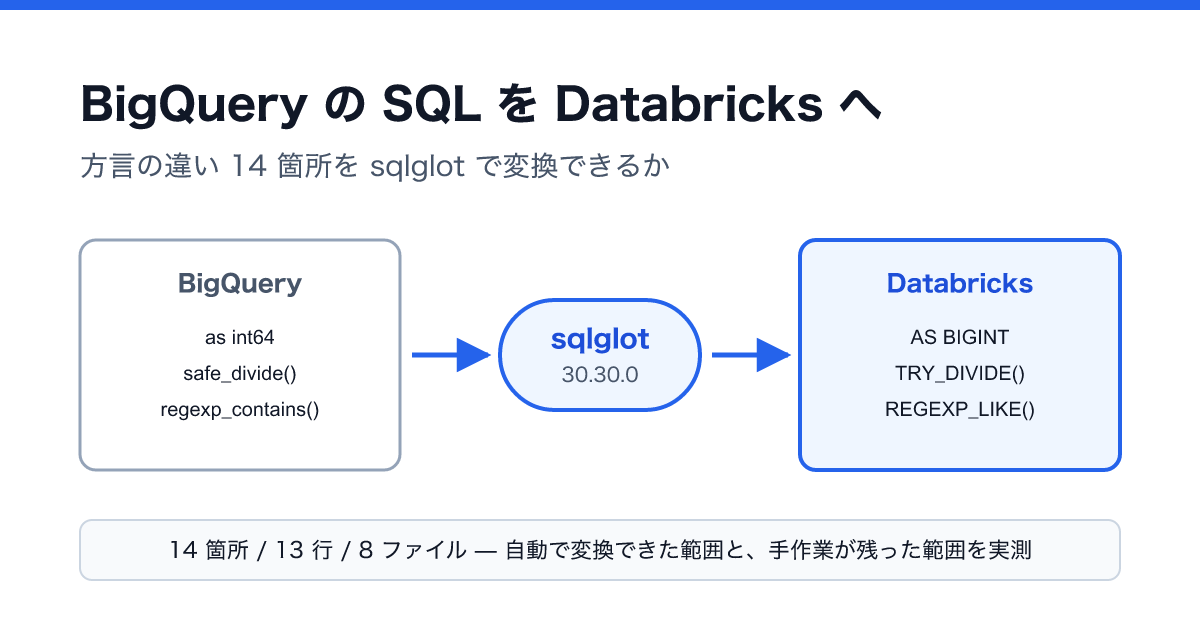
BigQuery で動かしている dbt(SQL でデータの加工処理を組み立てるツール)のモデルを、Databricks でも動かせるか試したい方向けの記事です。筆者が実際に移したときに手で書き直した14箇所について、無料の変換ツール sqlglot が同じ結果を出せるかを検証しました。読み終わると、移行の手作業のうちどこが機械に任せられて、どこが残るのかを見積もれるようになります。
この記事で分かること
- 1つのプロジェクトで、SQL の方言(データベースごとに違う SQL の書き方)の違いが出た箇所は14箇所だったこと
- その14箇所が sqlglot 30.30.0 で自動変換でき、出力が手作業の結果と一致したこと
- 一方で、dbt のファイルをそのまま sqlglot に渡すと失敗すること、配線の変更は自動化できないこと
この記事の数字は、筆者の1プロジェクト(政府統計 e-Stat を取り込む dbt モデル14ファイル)を対象にした結果です。他のプロジェクトでそのまま同じ割合になるとは限りません。
何を試したか
筆者は政府統計の API から取り込んだデータを、BigQuery 上の dbt で bronze / silver / marts の3層に加工していました。これを Databricks でも動かすため、SQL を Databricks 向けに手で書き直しました。
このとき書き直した箇所を、sqlglot に自動でやらせたらどうなるかを確かめます。sqlglot は Python 製のライブラリで、SQL を構文木(SQL の構造を木の形で表した中間表現)に読み込み、別の方言の書き方で出力し直します。
BigQuery 版の dbt モデル 14 ファイル
         |
         | (1) 方言依存の書き方を数える
         v
     14 箇所 / 13 行 / 8 ファイル
         |
         | (2) sqlglot で bigquery -> databricks に変換
         v
   sqlglot の出力
         |
         +--- (3) 手で書き直した版と構文木で比較
         |
         +--- (4) Databricks で実行して確認
方言の違いは14箇所、行で数えると13箇所
まず「14箇所」の数え方をはっきりさせます。BigQuery 版の14ファイルを対象に、Databricks に無い書き方を正規表現で検索しました。
grep -n -i -E "as int64|as float64|safe_cast|safe_divide|regexp_contains" \
  models/*/*.sql tests/*.sql
結果は次のとおりです。
| 探した言葉 | 出現数 | 備考 |
|---|---|---|
as int64(型名) | 4 | 3ファイルに分かれて出てきます |
as float64(型名) | 1 | 下の safe_cast と同じ1行に出てきます |
safe_cast(関数名) | 1 | 上の as float64 と同じ1行に出てきます |
safe_divide(関数名) | 7 | 5ファイルに分かれて出てきます |
regexp_contains(関数名) | 1 | |
| 合計 | 14 |
一方、grep が報告した行数は13行でした。差が出る理由は、as float64 と safe_cast が1行に同時に出ているためです。
-- 1 行に float64 と safe_cast の 2 箇所が入っている
else safe_cast(replace(value, ',', '') as float64)
つまり出現数で14箇所、行で数えると13行、ファイルで数えると8ファイルです。以降は出現数の14箇所を基準に話を進めます。
sqlglot を版を固定して動かす
結果を再現できるように、版を固定して実行しました。筆者は uv(Python の環境とパッケージを扱うツール)の一時環境を使い、sqlglot==30.30.0 を指定しました。
uv run --python 3.12 --with "sqlglot==30.30.0" python -I transpile.py変換そのものは1行です。read に元の方言、write に移したい方言を指定します。
import sqlglot

out = sqlglot.transpile(sql, read="bigquery", write="databricks", pretty=True)[0]
ここで1つ注意点があります。dbt のファイルは {{ source('bronze', 'bronze_estat_meta_info') }} のような Jinja(dbt が使うテンプレートの書き方)を含んでおり、sqlglot はこれを SQL として読めません。そのまま渡すと次のエラーで止まります。
ParseError: Expected table name but got <Token token_type: TokenType.L_BRACE, text: {, line: 8, col: 10>そのため、変換の前に Jinja の部分を仮の識別子(jinja_ph_0 など)へ置き換え、変換の後に元へ戻す処理を自分で書く必要がありました。
import re

JINJA = re.compile(r"\{\{.*?\}\}|\{%.*?%\}")

holes = []
def repl(m):
    holes.append(m.group(0))
    return "jinja_ph_%d" % (len(holes) - 1)

masked = JINJA.sub(repl, src)                     # Jinja を仮の名前に置き換える
out = sqlglot.transpile(masked, read="bigquery", write="databricks", pretty=True)[0]
for i, h in enumerate(holes):
    out = out.replace("jinja_ph_%d" % i, h)       # 変換後に元へ戻す
この置き換えは手作業です。「ファイルを渡せば終わり」ではない点は、見積もりのときに差し引いて考える必要があります。
結果:14箇所すべてが自動で変換された
変換後のファイルから、BigQuery 固有の書き方が残っているか、Databricks 向けの書き方に変わっているかを数え直しました。14箇所すべてが変換され、BigQuery 固有の書き方は1つも残りませんでした。
行の数ではなく出現数で数えているため、2行目は1行で2箇所分です(合計14箇所)。
| 元の書き方(BigQuery) | sqlglot の出力(Databricks) | 箇所数 |
|---|---|---|
as int64 | AS BIGINT | 4 |
safe_cast と as float64 | TRY_CAST と AS DOUBLE | 2 |
safe_divide | TRY_DIVIDE | 7 |
regexp_contains | REGEXP_LIKE | 1 |
2行目を2箇所と数えているのは、safe_cast と as float64 が同じ1行にあるためです。表に載せた書き方を、実際の式の形で並べると次のようになります。
-- 元の書き方(BigQuery)            -- sqlglot の出力(Databricks)
cast(left(time_code, 4) as int64)    CAST(LEFT(time_code, 4) AS BIGINT)
safe_cast(replace(value, ',', '')    TRY_CAST(REPLACE(value, ',', '')
  as float64)                          AS DOUBLE)
safe_divide(a, b)                    TRY_DIVIDE(a, b)
regexp_contains(area_code,           REGEXP_LIKE(area_code,
  r'^[0-9]{2}000$')                    '^[0-9]{2}000$')
変換の中身は、手で直したときの判断と同じでした。たとえば safe_divide は、0 で割っても止まらずに null を返す BigQuery の関数です。Databricks には同じ名前の関数が無く(try_divide の公式ドキュメント)、/ で割ると 0 除算のエラー(DIVIDE_BY_ZERO)になります。sqlglot はこれを単純な / ではなく TRY_DIVIDE に置き換えたので、0 除算でエラーにならない振る舞いが保たれました。
正規表現の扱いも確かめました。BigQuery の r'...'(バックスラッシュをそのまま扱う文字列)は、出力では r が外れます。ただしバックスラッシュを含む正規表現では、意味が変わらないように自動でエスケープされました。
-- 入力(BigQuery)
select regexp_contains(x, r'^\d{2}000$') from t
-- 出力(Databricks)
SELECT REGEXP_LIKE(x, '^\\d{2}000$') FROM t
手で書き直した版と一致するかを確かめた
「変換できた」だけでは、手作業の結果と同じかは分かりません。そこで sqlglot の出力と、手で書き直して実際に動かした Databricks 版を、1ファイルずつ比べました。
文字列のまま比べると、改行やキーワードの大文字・小文字の違いで差が出ます。そこで両方を sqlglot で構文木に読み込み、同じ条件(Databricks 方言・コメント無視)で出力し直してから比較しました。Jinja の部分は、BigQuery 版と Databricks 版で参照先の名前が違うため、両方とも同じ仮の識別子に置き換えています。
a = sqlglot.parse_one(mask(bigquery_src), read="bigquery").sql(dialect="databricks", comments=False)
b = sqlglot.parse_one(mask(databricks_src), read="databricks").sql(dialect="databricks", comments=False)
assert a == b結果は14ファイルすべてで一致しました(same=14 diff=0)。手で書き直した版は dbt のテストを含めて全件成功していたので、sqlglot の出力も同じ内容だったことになります。
Databricks で実際に実行して確かめた
比較だけでは「文字列として同じ」ことしか言えないため、sqlglot の出力そのものを Databricks の SQL ウェアハウスで実行しました。表を作り直すと既存のデータを壊すため、読み取りだけで済む dbt show --inline(SQL をその場で実行して先頭の数行を表示するコマンド)を使いました。
dbt show --inline "$(cat converted_model.sql)" --limit 114箇所を含む8ファイルすべてで成功し、失敗は0件でした。つまりこの実験では「文字列として直った」だけでなく、変換後の SQL が Databricks で実行できるところまで確認できています。
自動では直らなかったもの
一方で、移行作業のうち sqlglot が触れない部分もありました。筆者が手で直した変更には、方言とは別に次の2種類がありました。
| 変更 | 内容 | sqlglot で自動化できるか |
|---|---|---|
| データの置き場の配線 | 参照先の名前を書き換える | できない。Jinja と YAML の設定なので SQL の方言ではない |
| dbt のキー名 | tests: を data_tests: に変える | できない。dbt 側の書き方の変更 |
データの置き場の配線で書き換えたのは、次の2か所です。
source('bronze', ...)をsource('estat_raw', ...)に変えるdatabase: "{{ env_var('GCP_PROJECT') }}"をdatabase: workspaceに変える
BigQuery の「プロジェクト.データセット」は、Databricks では「カタログ.スキーマ」にあたります。この対応づけはプロジェクトごとの判断なので、ツールが決められる話ではありません。
注意したい点: 方言と関係ない部分も変わる
sqlglot は構文木を通して出力し直すため、方言と関係ない部分も形が変わります。差分レビューのときに驚かないよう、確認できたものを挙げます。
- ファイル全体が整形される: 改行位置、インデント、キーワードの大文字化がすべて変わります。元の整形は保てません。
- コメントの書き方と位置が変わる:
--が/* */になり、位置が動きます。筆者が数えたfact_estat_value.sqlでは、コメントの数は減りませんでした(3件 → 3件)。ほかのファイルでは数えていないため、どのファイルでも減らないとは言えません。 except distinctがEXCEPTになる: Databricks ではexcept distinctもそのまま動くので、この書き換えは必須ではありません。item_code is not nullがNOT item_code IS NULLになる: 意味は同じですが、読みやすさは落ちます。
いずれも意味は変わりませんが、差分が小さく収まることは期待できません。レビューでは、整形による差分と方言による差分を分けて見る必要があります。筆者は、同じファイルを write="bigquery" でも出力して比べ、両者の差分だけを方言由来として確認しました。
この結果をそのまま当てはめない方がよい点
この検証には範囲の限りがあります。
- 対象は1プロジェクト・14ファイルです。使っていた BigQuery 固有の機能は5種類に収まっており、配列や構造体を多用する SQL や、
_TABLE_SUFFIXによるワイルドカード参照は含まれていません。ウィンドウ関数(行の並び順を使って計算する関数)も、使ったのはrow_numberとlagだけで、ほかのウィンドウ関数の方言の差は試していません。 - 検証したのは
read="bigquery", write="databricks"の組み合わせだけです。 - 固定した版は sqlglot 30.30.0 です。sqlglot は更新が速いため、別の版では結果が変わる可能性があります。
- 実行して確かめたのは、方言の書き直しがある8ファイルです。行数や集計値の一致は、手で書き直した版で確認した結果です。
また、この検証に使った Databricks の環境は Free Edition(個人・非営利向けの無償版)です。規約がベンチマーク結果の公開を禁じているため、実行時間・費用・性能の数値はこの記事に載せていません。載せているのは「正しく変換できたか」という事実だけです。
使ったデータは政府統計の総合窓口(e-Stat)の統計データです(出典: 政府統計の総合窓口(e-Stat))。
関連する記事
- e-Stat × DuckDB × BigQuery × dbt で作る政府統計データ基盤 — この記事で移した dbt モデルを、BigQuery 側でどう組み立てたかを解説しています
まとめ
- 方言の違いは出現数で14箇所・13行・8ファイルでした。数え方を決めないと「14」と「13」が混ざるので、記事や報告では単位を書くべきです。
- sqlglot 30.30.0 は14箇所すべてを自動変換し、出力は手で書き直した版と構文木レベルで一致し、Databricks で実行できました。
- ただし dbt のファイルはそのまま渡せず(Jinja で
ParseErrorになる)、データの置き場の配線や dbt のキー名は手作業が残ります。方言の書き換えは任せられても、移行全体が自動化できるわけではありません。
分からない用語や、もっと詳しく知りたい箇所があれば遠慮なくお知らせください。